Claude Sonnet 5.5: Segundo en el Índice, Primero en Tokens
Claude Sonnet 5.5 salió el 28 de septiembre de 2026, con el mismo precio de lista que Sonnet 5 y que GPT-6 Sol: US$ 2 por millón de tokens de entrada y US$ 10 por millón de tokens de salida. Anthropic lo presenta como un complemento más rápido de Opus 5.5 para el trabajo bien delimitado. Artificial Analysis, al ejecutarlo de forma independiente en el esfuerzo máximo y con el fallback predeterminado activado, lo coloca segundo en el Intelligence Index: 56, dos puntos detrás de Opus 5.5 en 58, y 18 puntos por delante de Sonnet 5 en 38.
Ese segundo lugar es el extremo caro del modelo. La misma corrida usó unos 193 mil tokens de salida por tarea del índice, el mayor volumen que Artificial Analysis ha medido, cerca de un 60% más que Opus 5.5 en el máximo y unas siete veces GPT-6 Astra en el máximo. La tarea cuesta US$ 7,60. Opus 5.5 en el máximo cuesta US$ 5,98. La misma familia, la mitad del precio de lista en los tokens sin caché, y una factura más alta en el ajuste que produce la cifra de portada.
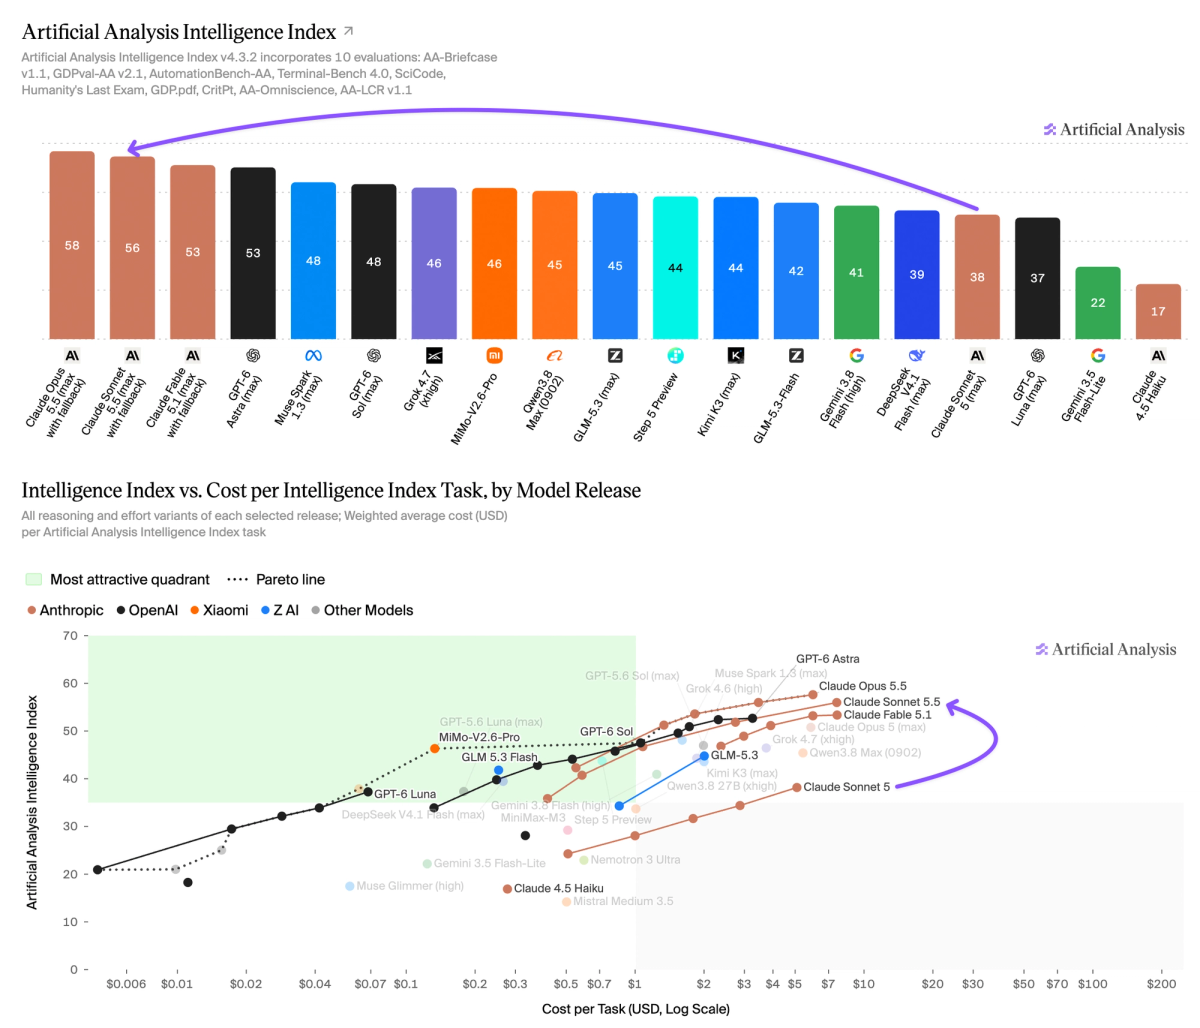
Artificial Analysis. Sonnet 5.5 en el máximo queda segundo en el índice y a la derecha de la frontera de costo, junto a Opus 5.5.
El ajuste es el producto
El id en la API es claude-sonnet-5-5. La ventana de contexto es de 1 millón de tokens. Claude Code y las apps de Claude usan medium como valor predeterminado. Claude Platform usa high. Ninguno de los dos predeterminados es la nota 56.
Artificial Analysis ejecutó los cinco niveles de esfuerzo. Abajo, la nota en el índice y el costo de una tarea del Intelligence Index.
| Esfuerzo | Intelligence Index | Costo por tarea | Tokens en la corrida completa del índice |
|---|---|---|---|
| Low | 36 | US$ 0,41 | 23 millones |
| Medium | 41 | US$ 0,59 | 29 millones |
| High | 47 | US$ 1,08 | 50 millones |
| Xhigh | 52 | US$ 2,74 | 100 millones |
| Max | 56 | US$ 7,60 | 410 millones |
De high a max, el índice pasa de 47 a 56 y el precio de la tarea pasa de US$ 1,08 a US$ 7,60. Cuatro de esos nueve puntos llegan en xhigh, por US$ 2,74. Los cuatro puntos finales, de 52 a 56, son el salto a US$ 7,60 y a 193 mil tokens de salida por tarea. La lectura de caché sigue en US$ 0,20, igual que la de Opus 5.5. Una ejecución hecha sobre todo de aciertos de caché tampoco sale a la mitad de Opus.
Artificial Analysis señala high como el ajuste competitivo: justo detrás de GPT-6 Sol en el índice, con prácticamente el mismo costo por tarea. Sol en el máximo marca 48 y cuesta unos US$ 1,06 en la corrida anterior. Sonnet en high marca 47 y cuesta US$ 1,08. En los esfuerzos más bajos, configuraciones de Sol o de Astra empatan la nota por menos dinero. El max se sale de la frontera y queda a la derecha de Opus.
La afirmación de Anthropic es de hasta un 30% menos de costo por tarea que Sonnet 5, por usar menos tokens, y una salida más de un 30% más rápida. Eso vale para sus propias cargas. En este índice, el esfuerzo máximo cuesta cerca de un 50% más por tarea que Sonnet 5, porque el modelo habla más. Las dos frases describen esfuerzos distintos.
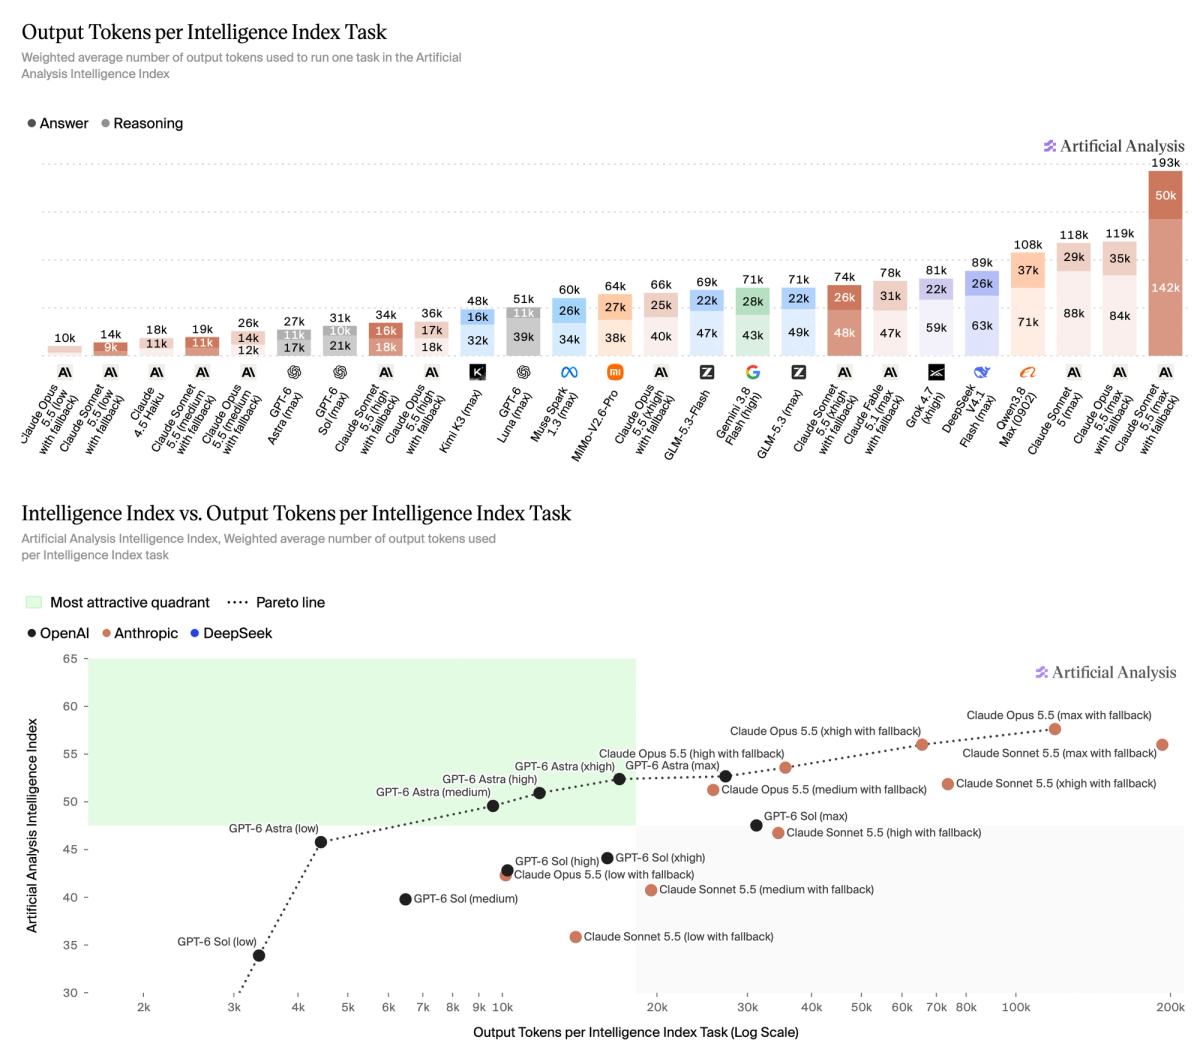
Artificial Analysis. La barra alta es Sonnet 5.5 en el máximo, unos 193 mil tokens de salida por tarea. Low, medium y high quedan bien a la izquierda.
Dónde se confirma el segundo lugar
En el Terminal-Bench 4.0 de Artificial Analysis, Sonnet 5.5 en el máximo marca 63,6%. Opus 5.5 marca 59,6%. GPT-6 Astra marca 59,1%. GPT-6 Sol marca 43,9%. Sonnet 5 en el máximo marca 14,1%. El texto de ellos redondea a los líderes a 64% y 60%. Es un liderato, en su harness, con el fallback activado. El modelo cayó a Sonnet 5 en cerca del 0,1% de las tareas del índice, casi todas dentro de este bench.
Terminal-Bench-Science es la comprobación. Sonnet 5.5 marca 53,3%. Astra lidera con 63,3%, Opus 5.5 queda en 59,0% y Sol en 30,0%. El liderato en tareas profesionales de terminal no se repite en los flujos de ciencia.
La tabla de lanzamiento de Anthropic es un tercer número, en el esfuerzo máximo de su propio setup: 70,6% en Terminal-Bench 4.0, cotizado en su gráfico de costo a US$ 12,54 por tarea. Lo mejor de Opus en ese gráfico es 66,4% en xhigh, por US$ 7,35. En medium, el predeterminado de Claude Code, Sonnet queda en 28,8% a US$ 0,83 y Opus en 57,6% a US$ 2,94. El 63,6% y el 70,6% son dos harnesses.
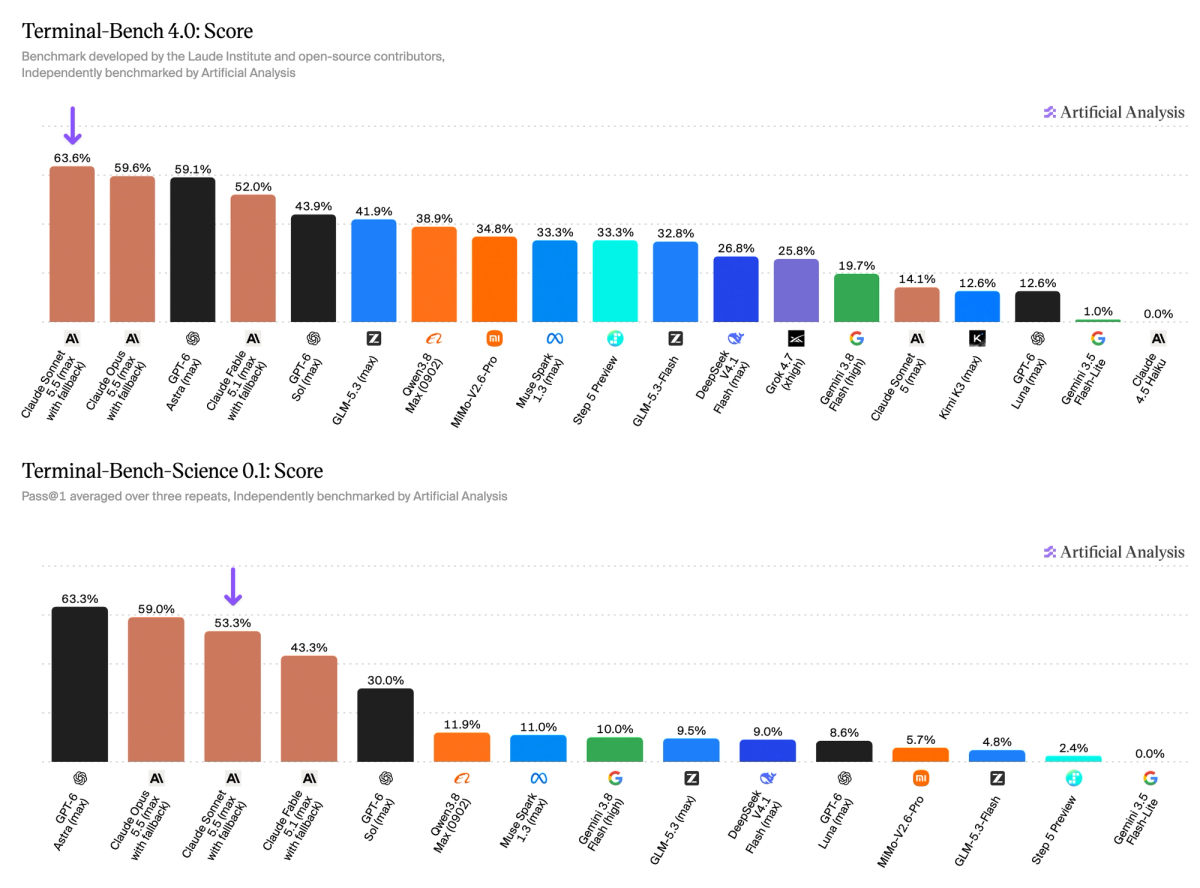
Artificial Analysis. Sonnet 5.5 lidera Terminal-Bench 4.0 con 63,6% y queda tercero en Terminal-Bench-Science con 53,3%.
El trabajo de conocimiento es el empate. AA-Briefcase queda en 1811 Elo, frente a 1822 de Opus. GDPval-AA queda en 1844, frente a 1846. AutomationBench-AA queda en 71%, frente a 70%. GPT-6 Sol, con los mismos US$ 2 y US$ 10, marca 1487 en GDPval y 1483 en Briefcase. El precio de lista coincide. El entregable, no.
La distancia aparece en el conocimiento factual. En AA-Omniscience, la exactitud de Sonnet es 54%, frente a 66% de Opus, y el índice es 32, frente a 46. La tasa de alucinación es menor, 47% frente a 59%. Se equivoca menos entre las respuestas que da, y sabe menos. SciCode queda en 61%, frente a 67% de Opus. Humanity's Last Exam, en este índice, queda en 55%, frente a 61%. Humanity's Last Exam con herramientas, de Anthropic, es otro setup: 64,5% frente a 67,7%. GDP.pdf empata en 26%.
Estas cifras de Artificial Analysis vienen de una versión previa al lanzamiento. Anthropic encontró un bug de structured output en esa versión, ya corregido, y espera que las notas subestimen un poco el modelo público. Artificial Analysis planea repetir las evaluaciones afectadas.
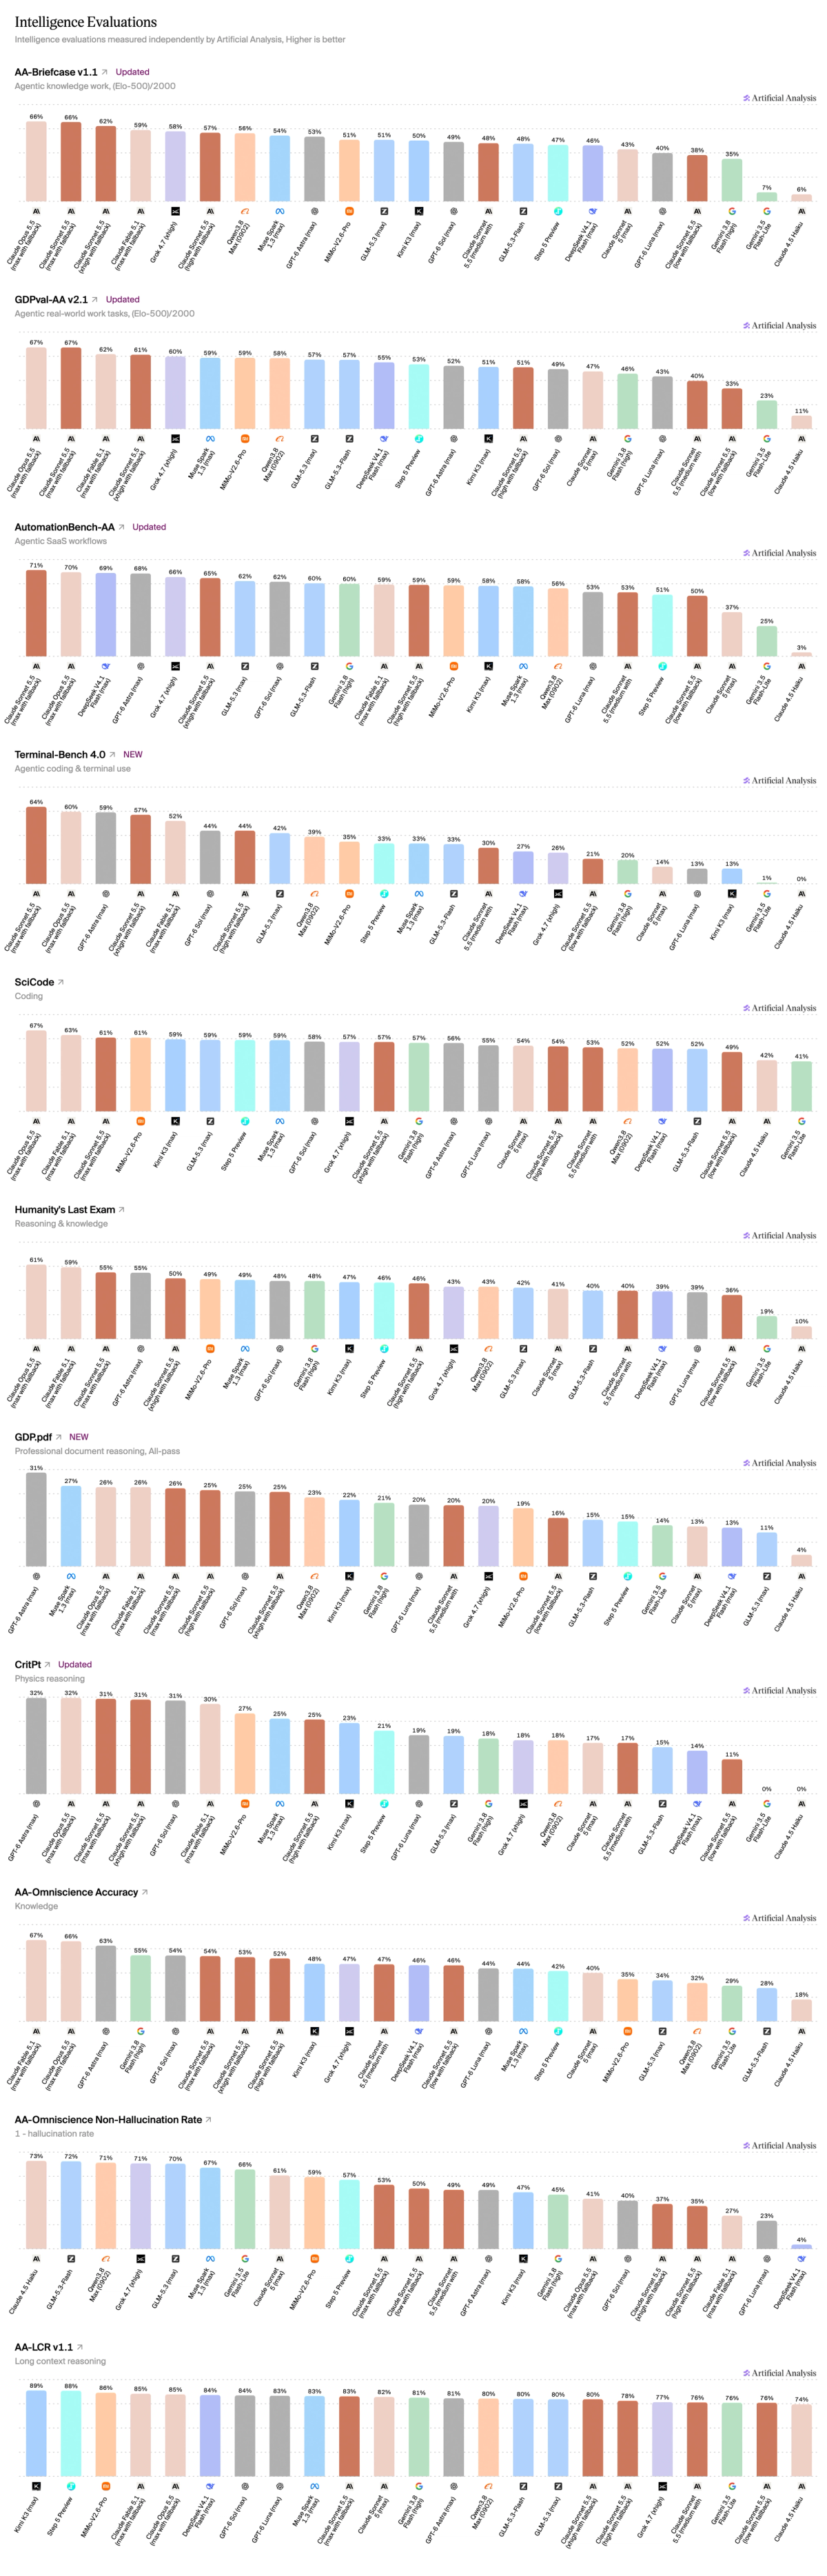
Artificial Analysis. Las barras de trabajo de conocimiento quedan junto a Opus en la parte alta. La separación está en AA-Omniscience, más abajo en la figura.
La curva de código de Anthropic dice lo mismo en dólares
Los gráficos de exactitud frente a costo de Anthropic son interactivos. Los puntos de abajo son sus etiquetas, una medida distinta de las