Claude Sonnet 5.5: Segundo no Índice, Primeiro em Tokens
O Claude Sonnet 5.5 saiu em 28 de setembro de 2026, com o mesmo preço de tabela do Sonnet 5 e do GPT-6 Sol: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. A Anthropic o apresenta como um complemento mais rápido do Opus 5.5 para trabalho bem delimitado. A Artificial Analysis, rodando o modelo de forma independente no esforço máximo e com o fallback padrão ligado, o coloca em segundo no Intelligence Index: 56, dois pontos atrás do Opus 5.5 em 58, e 18 pontos à frente do Sonnet 5 em 38.
Esse segundo lugar é a ponta cara do modelo. A mesma rodada usou cerca de 193 mil tokens de saída por tarefa do índice, o maior volume que a Artificial Analysis já mediu, cerca de 60% a mais que o Opus 5.5 no máximo e cerca de sete vezes o GPT-6 Astra no máximo. A tarefa custa US$ 7,60. O Opus 5.5 no máximo custa US$ 5,98. Mesma família, metade do preço de tabela nos tokens sem cache, e uma conta mais alta no ajuste que produz a nota de capa.
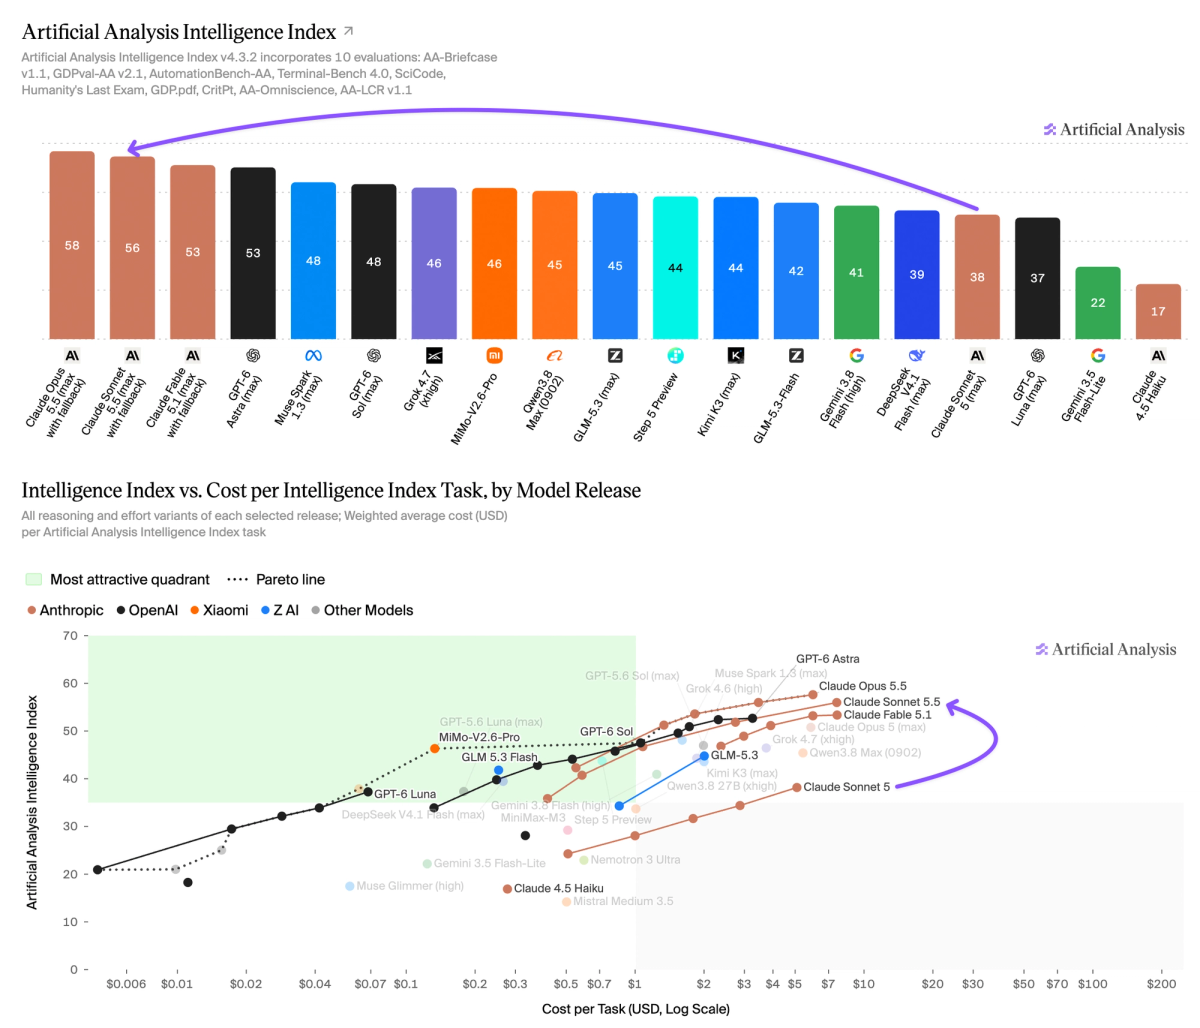
Artificial Analysis. O Sonnet 5.5 no máximo fica em segundo no índice e à direita da fronteira de custo, ao lado do Opus 5.5.
O ajuste é o produto
O id na API é claude-sonnet-5-5. A janela de contexto é de 1 milhão de tokens. O Claude Code e os apps do Claude usam medium como padrão. A Claude Platform usa high. Nenhum dos dois padrões é a nota 56.
A Artificial Analysis rodou os cinco níveis de esforço. Abaixo, a nota no índice e o custo de uma tarefa do Intelligence Index.
| Esforço | Intelligence Index | Custo por tarefa | Tokens na rodada inteira do índice |
|---|---|---|---|
| Low | 36 | US$ 0,41 | 23 milhões |
| Medium | 41 | US$ 0,59 | 29 milhões |
| High | 47 | US$ 1,08 | 50 milhões |
| Xhigh | 52 | US$ 2,74 | 100 milhões |
| Max | 56 | US$ 7,60 | 410 milhões |
Do high ao max, o índice vai de 47 a 56 e o preço da tarefa vai de US$ 1,08 a US$ 7,60. Quatro desses nove pontos chegam no xhigh, por US$ 2,74. Os quatro pontos finais, de 52 a 56, são o salto para US$ 7,60 e para 193 mil tokens de saída por tarefa. A leitura de cache continua em US$ 0,20, igual à do Opus 5.5. Uma execução feita sobretudo de acertos de cache também não sai pela metade do Opus.
A Artificial Analysis aponta o high como o ajuste competitivo: logo atrás do GPT-6 Sol no índice, com praticamente o mesmo custo por tarefa. O Sol no máximo marca 48 e custa cerca de US$ 1,06 na rodada anterior deles. O Sonnet no high marca 47 e custa US$ 1,08. Nos esforços mais baixos, configurações do Sol ou do Astra empatam a nota por menos dinheiro. O max sai da fronteira e fica à direita do Opus.
A afirmação da Anthropic é de até 30% menos custo por tarefa do que o Sonnet 5, por usar menos tokens, e saída mais de 30% mais rápida. Isso vale para as cargas deles. Neste índice, o esforço máximo custa cerca de 50% a mais por tarefa do que o Sonnet 5, porque o modelo fala mais. As duas frases descrevem esforços diferentes.
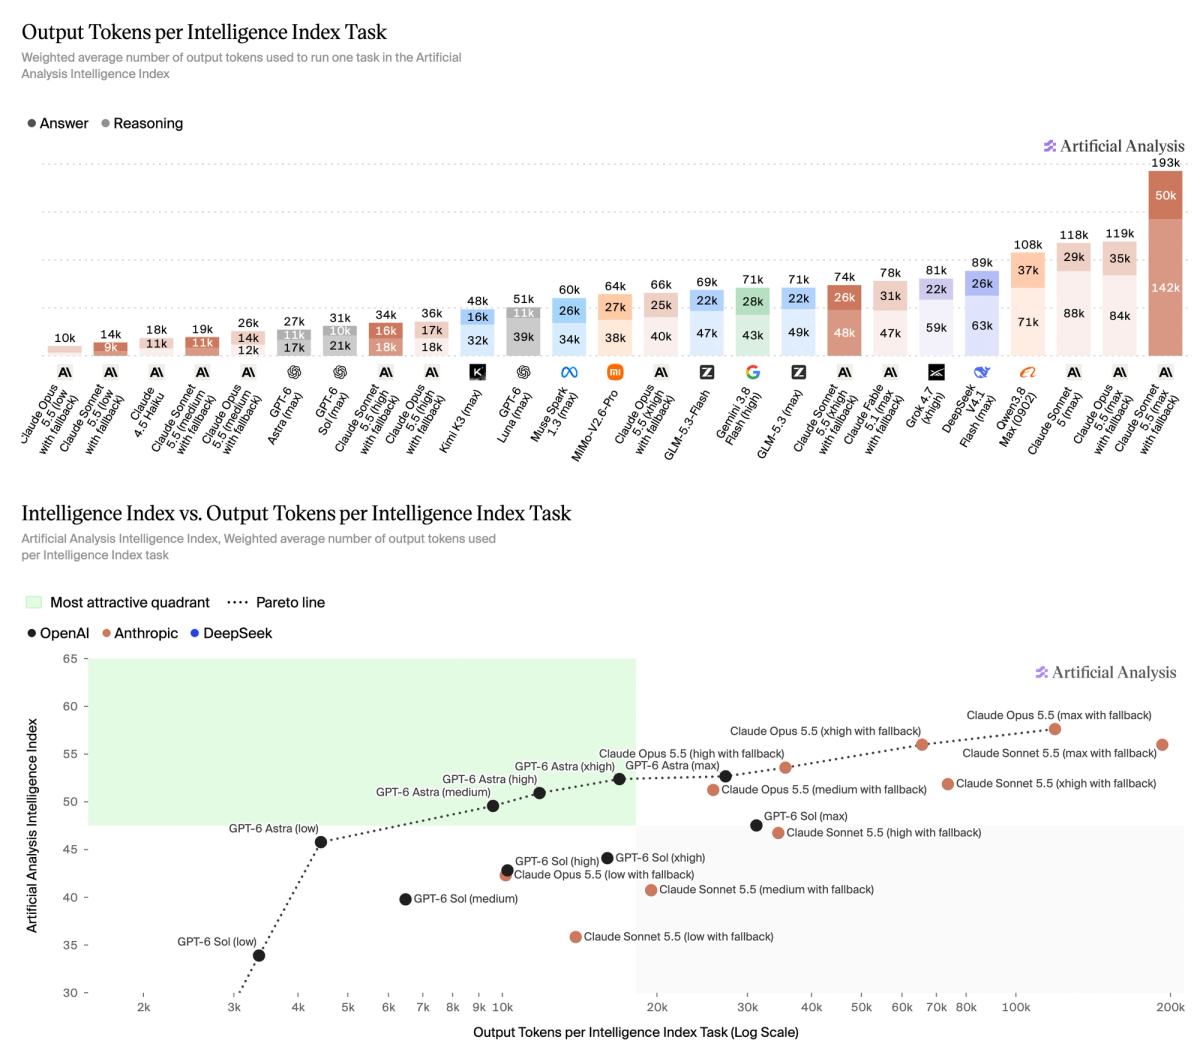
Artificial Analysis. A barra alta é o Sonnet 5.5 no máximo, cerca de 193 mil tokens de saída por tarefa. Low, medium e high ficam bem à esquerda.
Onde o segundo lugar se confirma
No Terminal-Bench 4.0 da Artificial Analysis, o Sonnet 5.5 no máximo marca 63,6%. O Opus 5.5 marca 59,6%. O GPT-6 Astra marca 59,1%. O GPT-6 Sol marca 43,9%. O Sonnet 5 no máximo marca 14,1%. O texto deles arredonda os líderes para 64% e 60%. É uma liderança, no harness deles, com o fallback ligado. O modelo caiu para o Sonnet 5 em cerca de 0,1% das tarefas do índice, quase todas dentro deste bench.
O Terminal-Bench-Science é a checagem. O Sonnet 5.5 marca 53,3%. O Astra lidera com 63,3%, o Opus 5.5 fica em 59,0% e o Sol em 30,0%. A liderança em tarefas profissionais de terminal não se repete nos fluxos de ciência.
A tabela de lançamento da Anthropic é um terceiro número, no esforço máximo do setup deles: 70,6% no Terminal-Bench 4.0, cotado no gráfico de custo deles a US$ 12,54 por tarefa. O melhor do Opus nesse gráfico é 66,4% no xhigh, por US$ 7,35. No medium, padrão do Claude Code, o Sonnet fica em 28,8% a US$ 0,83 e o Opus em 57,6% a US$ 2,94. Os 63,6% e os 70,6% são dois harnesses.
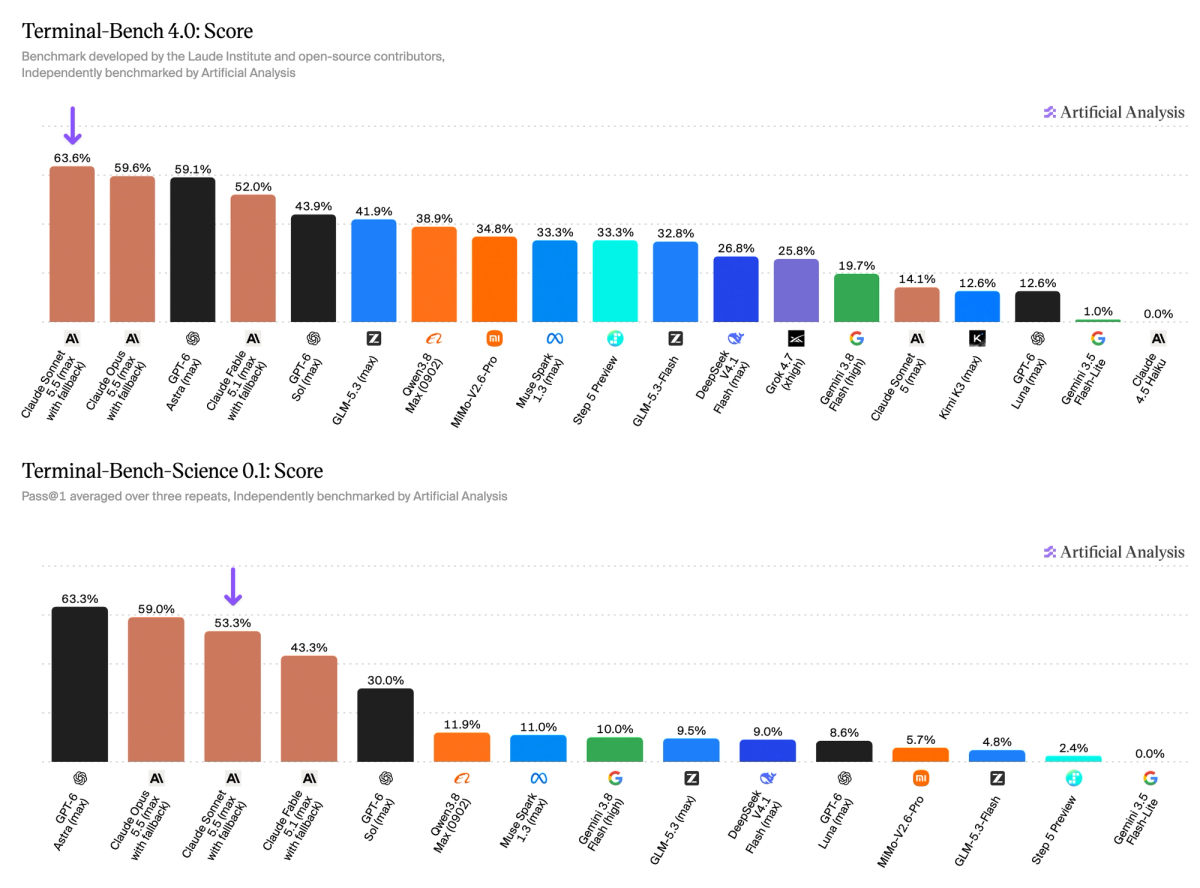
Artificial Analysis. O Sonnet 5.5 lidera o Terminal-Bench 4.0 com 63,6% e fica em terceiro no Terminal-Bench-Science com 53,3%.
O trabalho de conhecimento é o empate. O AA-Briefcase fica em 1811 Elo, contra 1822 do Opus. O GDPval-AA fica em 1844, contra 1846. O AutomationBench-AA fica em 71%, contra 70%. O GPT-6 Sol, com os mesmos US$ 2 e US$ 10, marca 1487 no GDPval e 1483 no Briefcase. O preço de tabela coincide. O entregável, não.
A distância aparece no conhecimento factual. No AA-Omniscience, a acurácia do Sonnet é 54%, contra 66% do Opus, e o índice é 32, contra 46. A taxa de alucinação é menor, 47% contra 59%. Ele erra menos entre as respostas que dá, e sabe menos. O SciCode fica em 61%, contra 67% do Opus. O Humanity's Last Exam, neste índice, fica em 55%, contra 61%. O Humanity's Last Exam com ferramentas, da Anthropic, é outro setup: 64,5% contra 67,7%. O GDP.pdf empata em 26%.
Esses números da Artificial Analysis vêm de uma versão pré-lançamento. A Anthropic encontrou um bug de structured output nessa versão, já corrigido, e espera que as notas subestimem um pouco o modelo público. A Artificial Analysis pretende refazer as avaliações afetadas.
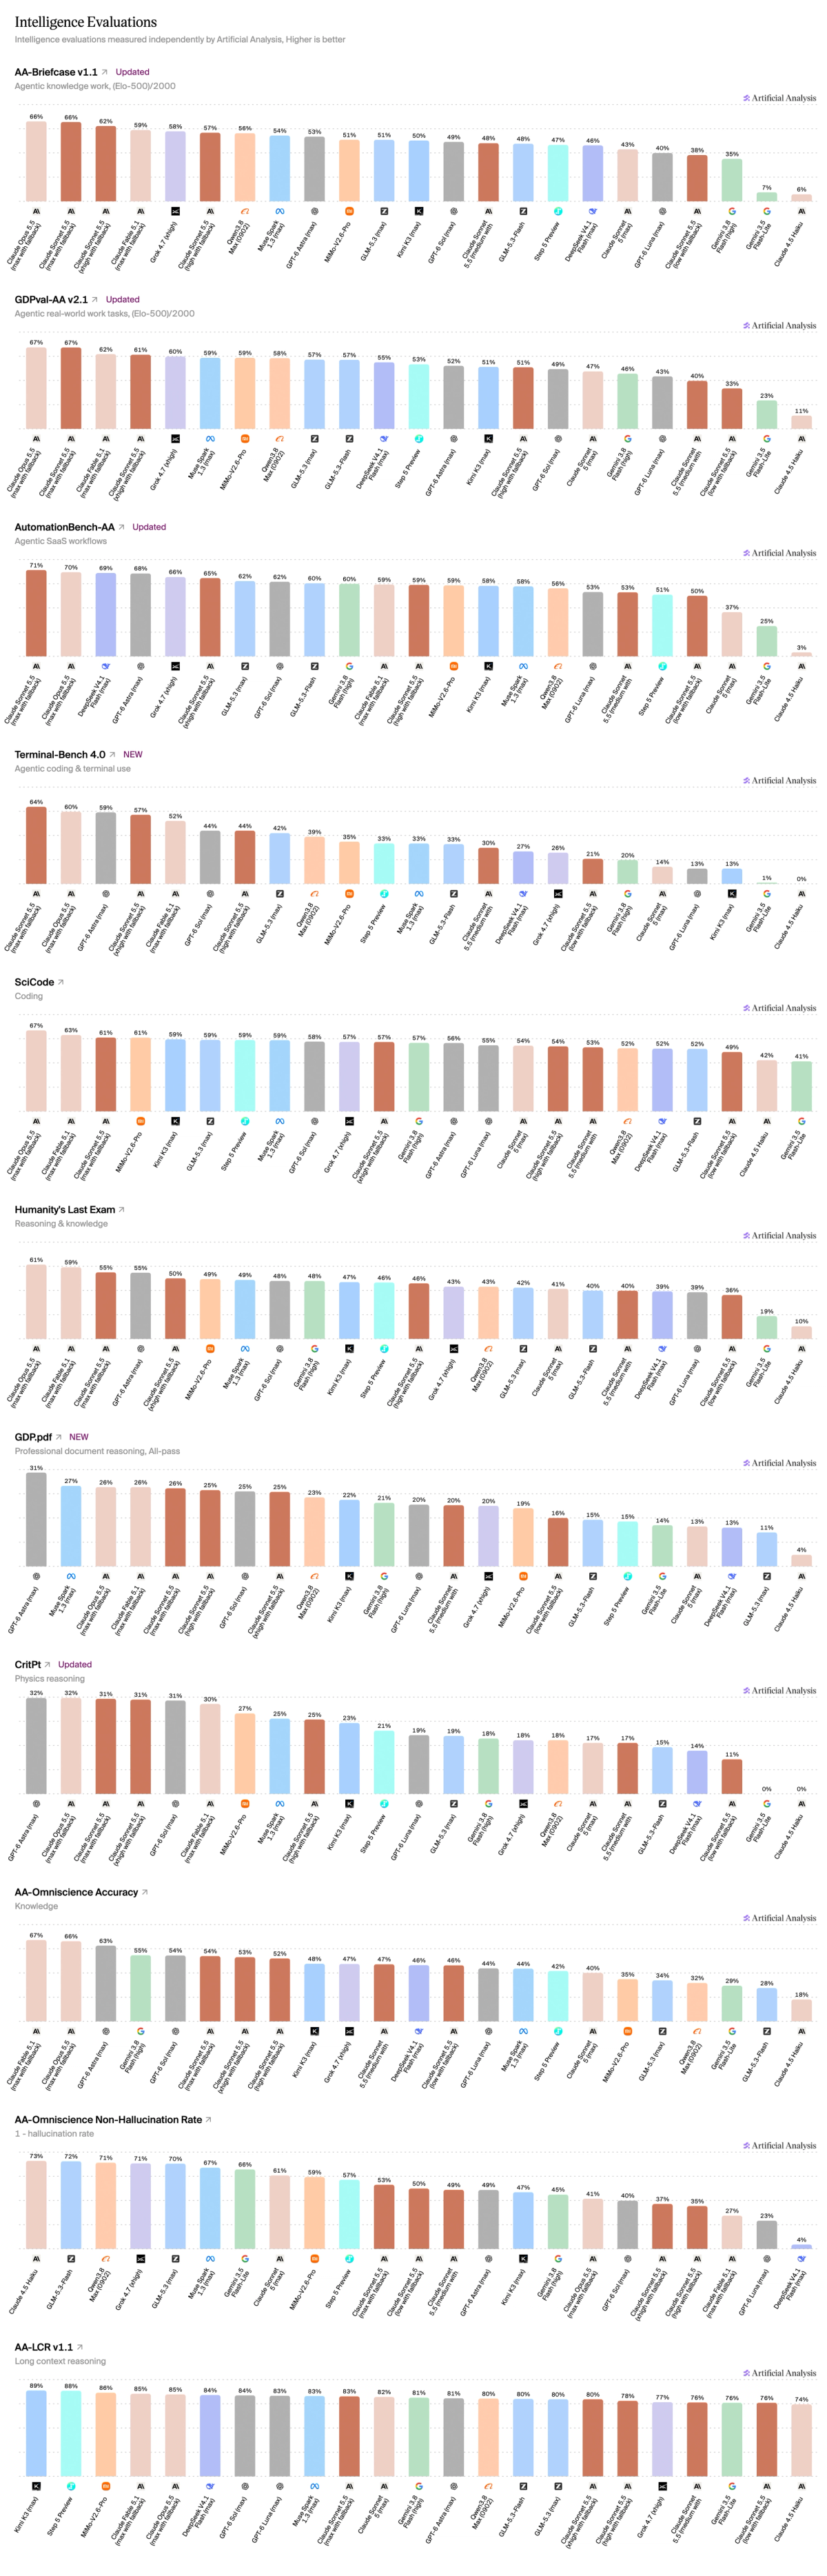
Artificial Analysis. As barras de trabalho de conhecimento ficam junto do Opus no topo. A separação está no AA-Omniscience, mais abaixo na figura.
A curva de código da Anthropic diz o mesmo em dólares
Os gráficos de acurácia contra custo da Anthropic são interativos. Os pontos abaixo são os rótulos deles, uma medida separada das cifras da Artificial Analysis.
No FrontierCode, no esforço high, padrão da Platform, o Sonnet marca 49,4% a US$ 0,42. Isso empata o melhor do GPT-6 Sol, 49,3% a US$ 2,07. O xhigh é o melhor do Sonnet neste bench, 52,1% a US$ 1,59. O max cai para 46,2% e custa US$ 20,78. O Opus no medium já está em 54,6% a US$ 0,80. A queda no max está na nota de rodapé deles: o FrontierCode penaliza edições fora da tarefa, e no max o modelo passou a dividir a revisão de código entre vários subagentes. Em dois casos que a Cognition examinou, isso estourou o tempo ou editou além da tarefa.
No CursorBench, o melhor do Sonnet é 55,5% a US$ 9,67. O Opus no high já está em 56,0% a US$ 3,97.
O que muda no agente
O Sonnet 5.5 é o primeiro Sonnet com salvaguardas de cibersegurança do tipo usado nos modelos mais capazes da Anthropic. Tarefas de cibersegurança de maior risco caem para o Sonnet 5. As salvaguardas de biologia continuam as do Sonnet 5. Uma recusa volta como HTTP 200 com stop_reason: "refusal".
Não dá para enviar o pensamento como disabled. O ajuste mais baixo é between_tools, e só em high ou abaixo. Escolha forçada de ferramenta devolve erro. Os blocos de pensamento deste modelo ficam neste modelo: Opus 5, Opus 5.5, Fable e Mythos não os leem, e o Sonnet 5.5 não lê os deles. Em contas de API criadas em 31 de agosto de 2026 ou depois, editar o histórico antes de um desses blocos devolve 400. Na Claude API e no Google Cloud, a ferramenta antiga de uso do computador, computer_20251124, é recusada. A ferramenta de advisor recusa Opus 4.8, Opus 4.7 e Sonnet 5 como advisors.
Na prática
- Trate a nota 56 como esforço max. Ela custa US$ 7,60 por tarefa do índice e cerca de 193 mil tokens de saída. O Opus 5.5 no max marca 58 e custa US$ 5,98. Compre o max quando os quatro pontos finais do índice valerem esse salto, a partir do xhigh a US$ 2,74.
- No agente padrão, use high. A Platform já faz isso. O índice fica em 47 a US$ 1,08, ao lado do GPT-6 Sol no max, 48 a cerca de US$ 1,06. O medium, padrão do Claude Code e dos apps, fica em 41 a US$ 0,59, e a Artificial Analysis coloca Sol e Astra à frente dele na fronteira de custo.
- Passe para cá o trabalho de conhecimento bem delimitado quando a comparação for o preço sem cache do Opus. O Briefcase fica em 1811 contra 1822, e o GDPval em 1844 contra 1846. Deixe o trabalho factual em aberto no Opus. A acurácia no Omniscience é 54% contra 66%.
- Deixe terminal científico e FrontierCode no max fora deste modelo. O Terminal-Bench-Science fica em 53,3%, atrás do Astra em 63,3% e do Opus em 59,0%. O FrontierCode no max fica em 46,2% a US$ 20,78. O xhigh fica em 52,1% a US$ 1,59.
- Cite o Terminal-Bench como dois resultados. A Artificial Analysis tem 63,6%, à frente do Opus em 59,6%. O gráfico de lançamento da Anthropic tem 70,6% no max por US$ 12,54, contra o Opus em 66,4% por US$ 7,35.
- Uma execução feita sobretudo de acertos de cache paga a mesma leitura de US$ 0,20 do Opus. A metade do preço vale para a entrada e a saída sem cache.
- Antes de apontar um agente de Sonnet 5 para este id, troque o pensamento para between_tools, tire a escolha forçada de ferramenta e tire Opus 4.8, Opus 4.7 e Sonnet 5 da lista de advisors. Uma recusa de cibersegurança pode cair para o Sonnet 5. Uma recusa de biologia continua recusada.
Fontes: Artificial Analysis sobre o Sonnet 5.5, as páginas de esforço, a comparação com o Opus 5.5 e o lançamento da Anthropic. Índice, tokens e os quatro gráficos são da Artificial Analysis no max com fallback, salvo quando a tabela de esforço diz outra coisa. Os preços de FrontierCode e CursorBench são dos gráficos da Anthropic.